Automatisches Backup für den DevOps-Stack
Überwinden Sie die Grenzen nativer und manueller Backups mit einer Compliance-konformen, audit-fähigen und automatischen Backup-Strategie.


Überwinden Sie die Grenzen nativer und manueller Backups mit einer Compliance-konformen, audit-fähigen und automatischen Backup-Strategie.

Passen Sie den Aufbewahrungszeitraum an Ihre Compliance-Anforderungen an. Sichern Sie Ihre Repositorys automatisch mit allen kritischen Metadaten.

Sichern Sie Ihre Daten automatisch auf mehreren Recovery Points Ihrer Wahl und halten Sie RPO und Datenverlust auf einem absoluten Minimum.

Lenken Sie wertvolle Entwicklerstunden vom Schreiben, Korrigieren und Warten von DIY-Backup-Skripten in Bereiche um, die Ihren ROI direkt steigern.

Audits bestehen, ohne Workflows zu unterbrechen. Automatisierte Protokolle und SLA-Berichte halten Sie kontinuierlich bereit für SOC 2- oder ISO 27001-Audits.
Bleiben Sie gegen Angriffsvektoren gewappnet, die kritische Sicherheitsrisiken verursachen und die Geschäftskontinuität gefährden.

Git-Plattformen garantieren die Infrastrukturverfügbarkeit – aber Ihre Organisation trägt die alleinige Verantwortung dafür, die darin gespeicherten DevOps-Daten zu sichern, aufzubewahren und zu schützen.

Native Papierkörbe und einfache Klone ignorieren wichtige Metadaten – wie Pull Requests, Issues und Wikis – und machen eine vollständige, nutzbare Umgebungswiederherstellung unmöglich.

Native Aufbewahrungsfristen von 30 Tagen erfüllen die Compliance-Anforderungen von Enterprise-Standards wie SOC2 und ISO 27000 bei Weitem nicht – und setzen Sie damit dem Risiko empfindlicher Bußgelder und Geschäftsunterbrechungen aus.

Interne Skripte schlagen bei API-Änderungen stillschweigend fehl und hinterlassen oft veraltete Backups, die sechs Monate alt sind – und verwandeln so einen beherrschbaren Ausfall in eine Katastrophe.

Ausführen individuelle Backup-Zeitpläne abgestimmt auf den Workflow Ihres Teams. Minimieren Sie Datenverluste mit RTO nahe null und optimieren Sie den Speicherplatz durch automatisierte Aufbewahrung Richtlinien.

Backup-Daten automatisch replizieren auf mehrere Speicherziele– in der Cloud oder On-Premise. Stellen Sie unterbrechungsfreie Datenverfügbarkeit sicher, indem Sie die 3-2-1-Backup-Regelautomatisieren.

Konfigurieren Sie Ihre Backups, um das gesamte Ökosystem zu sichern –einschließlich Metadaten wie Pull Requests, Issues, Wikis und Kommentare – damit Sie eine vollständig funktionierende Arbeitsumgebungautomatisieren.

Nutzen Sie Webhooks und REST-APIs, um automatisch Backups nach bestimmten Ereignissen auszulösen– z. B. bei jedem Pull Request – und stellen Sie sicher, dass jede Code-Änderung vor dem Deployment gesichert ist.

Erreichen Sie vollständige Datennachverfolgbarkeit. Erhalten Sie täglich SLA-Zusammenfassungen via Slack, E-Mail oder Webhooks, und verlassen Sie sich auf unveränderliche, erweiterte Audit-Logs um Compliance bei Sicherheitsaudits sofort nachzuweisen.

Flexible Richtlinien, Cron-basiertes Scheduling, GFS, FIFO, Forever Incremental.
Geplant, On-Demand, ereignisgesteuert (Webhooks, REST API).
Auto-Discovery und automatische Einbindung neu erstellter Repositorys und Metadaten.
Slack, E-Mail, Webhooks, erweiterte Audit-Logs und tägliche SLA-Berichte.
Anpassbare, langfristige und unbegrenzte Aufbewahrungsrichtlinien mit granularer Archivierung für nicht genutzte Repositorys.
Automatisierte Any-to-Any-Replikation (Cloud/Lokal/Hybrid) ohne Auswirkungen auf API-Ratenlimits.
Sofortiges Disaster Recovery, granulare Wiederherstellung und kostenfreie Test-Wiederherstellung in eine leere Sandbox-Umgebung.
Repositories with metadata, including issues, merge requests, hooks, keys, wiki and more.
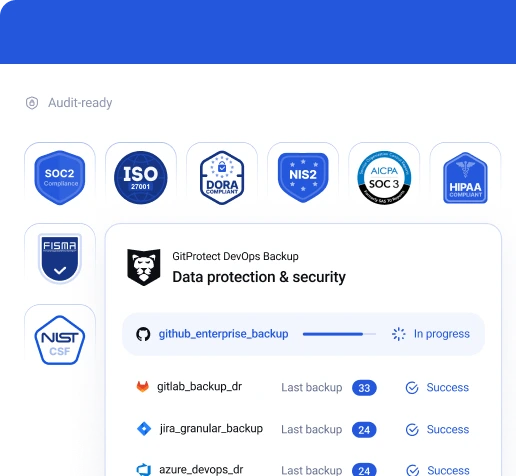

Wir betreiben ein sicheres Informationssicherheits-Managementsystem und sind umfassend auf die Abwehr von Bedrohungen vorbereitet.

Wir setzen strenge Datensicherheits- und Datenschutzkontrollen um, um Ihre Zertifizierungsanforderungen effektiv zu unterstützen.

Unser Cloud-Speicher nutzt hochsichere Rechenzentren in den USA oder der EU, die mit ISO 27K1, SOC 2 Type II, EN 50600, HIPAA, FISMA und weiteren Standards konform sind.


Entdecken Sie, wie einfach Sie Ihren DevOps-Backup mit GitProtect vollständig automatisieren.
Demo anfordernStellen Sie sicher, dass Ihre Backup-Strategie auf jedes Disaster-Szenario vorbereitet ist
Compliance-Standards wie SOC 2 Type II, ISO 27001, NIS2 und HIPAA schreiben strenge Datenschutzrichtlinien vor, einschließlich regelmäßiger Backups, Disaster-Recovery-Pläne und sicherer Datenverarbeitung.
Die Automatisierung Ihres DevOps-Backups wandelt diese komplexen regulatorischen Anforderungen in einen reibungslosen Hintergrundprozess um. Anstatt Backup-Status manuell zu verfolgen und Dokumentationen zu erstellen, stellt ein automatisiertes System sicher, dass Ihre Richtlinien konsequent und ohne menschliche Eingriffe durchgesetzt werden.
Bei einem Audit zählen Nachweise. Eine automatisierte Backup-Lösung liefert kontinuierliche, nachprüfbare Belege für Ihre Datenresilienz. Sie erstellt automatisch detaillierte Protokolle, umfassende SLA-Berichte und sofortige Benachrichtigungen, die Prüfer benötigen. So weisen Sie mühelos nach, dass Ihre Organisation die geforderten Richtlinien zur Datenaufbewahrung, Backup-Häufigkeit und Disaster-Recovery-Bereitschaft einhält.
Darüber hinaus sichern automatisierte Tools auf Enterprise-Niveau Ihre Daten sowohl während der Übertragung als auch im Ruhezustand mit AES-256-Verschlüsselung und Ihrem eigenen Verschlüsselungscode. Dieses hohe Maß an Sicherheits-Governance stellt sicher, dass Ihr sensibles geistiges Eigentum selbst im Falle eines Sicherheitsvorfalls unlesbar und geschützt bleibt – und die strengen Sicherheitsanforderungen globaler Compliance-Frameworks vollständig erfüllt.
Mehr über GitProtect Backup Compliance erfahrenWer seine kritischen DevOps-Daten an einem einzigen Speicherort ablegt, schafft einen erheblichen Single Point of Failure (SPOF). Fällt genau diese Infrastruktur aus, wird durch Ransomware kompromittiert oder von einer Naturkatastrophe getroffen, ist das gesamte geistige Eigentum Ihrer Organisation nicht mehr zugänglich.
Automatisierte Multi-Storage-Replikation begegnet dieser Schwachstelle direkt, indem sie der goldenen 3-2-1-Backup-Regel folgt und sicherstellt, dass Ihre Daten nie auf einen einzigen gefährdeten Speicherort beschränkt sind.
Durch die Automatisierung dieses Prozesses sendet Ihr Backup-System verschlüsselte Kopien Ihrer Repositorys und Metadaten gleichzeitig an mehrere separate Speicherziele. Sie replizieren Ihre Backups nahtlos über verschiedene Cloud-Anbieter – wie AWS, Azure oder Google Cloud – sowie Ihre eigenen lokalen On-Premise-Server. Diese Redundanz garantiert, dass Ihre Recovery-Kapazitäten vollständig unabhängig von der Verfügbarkeit oder Infrastruktur eines einzelnen Anbieters sind.
In einem kritischen Disaster Recovery Szenario ist diese automatisierte Replikation ein echter Lebensretter. Wird Ihr primärer Backup-Speicher kompromittiert oder vorübergehend nicht verfügbar, ruft Ihr automatisiertes System die benötigten Daten sofort von einem alternativen Speicherort ab. Das gewährleistet echte 360-Grad-Cyberresilienz, minimiert Ausfallzeiten erheblich und ermöglicht Ihren Entwicklungsteams, ihre Arbeit ohne schwerwiegende Unterbrechungen fortzusetzen.
GitProtect Multi-Storage-Backup-Funktionen entdeckenEin weit verbreitetes Missverständnis in der DevOps-Sicherheit ist die Annahme, dass Cloud-Hosting-Plattformen wie GitHub, GitLab, Jira oder Bitbucket Ihre Daten automatisch vor Verlust schützen. Tatsächlich arbeiten diese Anbieter nach dem Shared Responsibility Model. Sie garantieren die Verfügbarkeit und den Betrieb ihrer Infrastruktur – die eigentlichen Daten, einschließlich Quellcode, Issues und Metadaten, zu sichern liegt jedoch vollständig in der Verantwortung Ihrer Organisation.
Native Schutzfunktionen wie einfache Papierkörbe oder grundlegende Repository-Klone sind für Enterprise-Sicherheit grundsätzlich ungeeignet. Sie bieten nur sehr begrenzte Aufbewahrungszeiträume und ignorieren kritische Metadaten häufig vollständig.
Verschlüsselt ein gezielter Ransomware-Angriff Ihre Repositorys oder löscht ein böswilliger Insider absichtlich Ihre Projekte, bieten native Tools keine zuverlässige Point-in-Time Recovery-Option – Ihr Unternehmen bleibt dem Risiko eines dauerhaften Datenverlusts ausgesetzt.
Wer sich ausschließlich auf die Plattform selbst verlässt, speichert sein Backup in derselben Umgebung wie die Produktionsdaten. Bei einem schwerwiegenden globalen Ausfall oder einer ernsthaften Sicherheitsverletzung verlieren Sie gleichzeitig den Zugriff auf Ihren Live-Code und Ihre nativen Backups. Eine automatisierte Drittanbieter-Backup-Lösung stellt sicher, dass Ihre Daten isoliert, verschlüsselt und für die plattformübergreifende Wiederherstellung bereit sind – auch wenn der primäre Anbieter ausfällt.
Mehr über das Shared Responsibility Model und DevOps-Backup erfahrenViele Unternehmen versuchen zunächst, ihre DevOps-Backups mit internen „Do-it-yourself“-Skripten zu verwalten. Diese manuellen Skripte sind jedoch sehr fehleranfällig und stellen ein erhebliches Sicherheitsrisiko dar. Sie erfordern ständige, aufwändige Aktualisierungen, sobald sich die API von Plattformen wie GitHub oder Jira ändert.
Wenn ein Skript stillschweigend ausfällt, kann Ihre Organisation monatelang unter der falschen Annahme arbeiten, dass Backups laufen – bis der Ausfall bei einem katastrophalen Datenverlust ans Licht kommt.
Manuelle Skripte decken zudem selten die vollständigen Anforderungen an Disaster Recovery ab. Ein Skript zu schreiben, das Daten aus einer Plattform extrahiert, ist nur 30 % der Arbeit – die eigentliche Herausforderung liegt im Wiederherstellungsprozess. DIY-Lösungen verfügen in der Regel nicht über automatisierte, getestete Wiederherstellungsumgebungen, was granulare Wiederherstellungen erheblich erschwert, plattformübergreifende Wiederherstellung auf andere Plattformen, oder Point-in-Time-Recovery ohne massive Datenbeschädigung.
Eigenentwickelte Skripte verfügen oft nicht über wesentliche Sicherheitsfunktionen wie robuste Verschlüsselung, Ransomware-Schutz, und Multi-Storage-Replikation. Sie lassen sich nur schwer skalieren, wenn das Daten-Ökosystem wächst – insbesondere bei großen Repositorys oder umfangreichen Pull-Request-Verläufen. Das Vertrauen auf ein ungetestetes Skript in einer Krise erhöht Ihre Recovery Time Objective (RTO) erheblich und kostet das Unternehmen wertvolle Zeit und Umsatz.
Mehr über die tatsächlichen Kosten von DevOps-Backup-Skripten erfahrenDie Annahme, dass DIY-Backup-Skripte „kostenlos“ sind, ignoriert die erheblichen versteckten Kosten für ihre Wartung und Ausführung. Entwicklung, Überwachung, Fehlerbehebung und Aktualisierung eines eigenen Skripts erfordern Hunderte von Stunden Ihrer erfahrenen DevOps-Engineers. Das sind teure Ressourcen, die sich auf die Entwicklung zentraler Produktfunktionen und den ROI Ihres Unternehmens konzentrieren sollten – nicht auf die Betreuung instabiler und unzuverlässiger Backup-Infrastruktur.
Automatisierte Backup-Lösungen beseitigen diese versteckten Wartungskosten durch eine vollständig verwaltete „Set-it-and-forget-it“-Umgebung. Das System verarbeitet API-Änderungen automatisch, skaliert mit Ihrem wachsenden Datenvolumen und sendet sofortige Benachrichtigungen bei auftretenden Problemen. Diese Planbarkeit verwandelt eine operative Belastung in eine feste, kalkulierbare Investition – sie steigert die Produktivität Ihres Teams erheblich und setzt verborgenes IT-Potenzial frei.
Noch wichtiger: Automatisierung spart Geld, indem sie die gravierenden finanziellen Folgen von Ausfallzeiten minimiert. Bei einem Ausfall oder einem Ransomware-Angriff stellt ein dediziertes Tool mit einer bewährten Disaster Recovery-Strategie Ihr gesamtes System in Minuten statt in Tagen wieder her. Wer massive Umsatzverluste, Reputationsschäden und Compliance-Bußgelder durch längere Datenunavailability vermeidet, trifft mit automatisierten Backups die finanziell klügste Entscheidung.
Mehr zur Disaster Recovery-Strategie in DevOpsJa, eine wirklich automatisierte Backup-Lösung auf Enterprise-Niveau ist darauf ausgelegt, dynamisch mit Ihrer Organisation zu wachsen. DevOps-Umgebungen sind hochdynamisch: Entwickler erstellen ständig neue Repositorys, legen neue Jira-Projekte an und fügen neue Boards hinzu. Einen Administrator damit zu beauftragen, den Backup-Plan bei jedem neuen Asset manuell zu aktualisieren, ist ineffizient und führt unweigerlich dazu, dass kritische Daten übersehen werden.
GitProtect schließt diese Schwachstelle, indem es sich kontinuierlich mit Ihren DevOps-Plattformen synchronisiert. Sobald Sie Ihre GitHub-, GitLab-, Bitbucket- oder Jira-Umgebungen verbinden, erkennt das System neu erstellte Repositorys oder Projekte automatisch und fügt sie sofort in Ihre vordefinierten Backup-Richtlinien ein. Diese automatische Erkennung stellt sicher, dass Ihr Schutzperimeter stets aktuell bleibt – ganz ohne manuellen Eingriff.
Diese Auto-Scaling-Funktion sorgt für absolute Sicherheit – sowohl für DevOps-Teams als auch für Sicherheitsverantwortliche. Ob Sie zehn Repositorys oder zehntausend verwalten: Jedes neue Code-Snippet, jedes Issue und jedes Metadaten-Element wird vom ersten Tag an gesichert. Mit dynamischen Regeln weisen Sie neue Assets automatisch bestimmten Speicherzielen oder Aufbewahrungsfristen zu – genau nach Ihren organisatorischen Anforderungen.
Besuchen Sie unsere DevOps Backup Academy und erfahren Sie mehr über die automatischen Backups von GitProtect.Recovery Point Objective (RPO) legt fest, wie viel Datenverlust Ihre Organisation maximal tolerieren kann. Automatisierte Backups senken Ihren RPO erheblich, da Sie häufige, kontinuierliche oder unbegrenzt inkrementelle Backups planen können.
Da der Prozess kontinuierlich im Hintergrund läuft, entstehen über den Tag verteilt mehrere Recovery-Punkte. So bleibt der Datenverlust auch im schlimmsten Fall auf ein absolutes Minimum begrenzt.
Recovery Time Objective (RTO) misst die maximale akzeptable Ausfallzeit, bevor Ihr Betrieb wiederhergestellt sein muss. Automatisierte Backup-Tools bieten umfassende Disaster Recovery-Funktionen, die Ihren RTO drastisch reduzieren.
Statt manuell fragmentierte Skripte zusammenzusetzen, erhalten Sie sofortigen Zugriff auf planbare Wiederherstellungsszenarien – einschließlich Point-in-Time-Recovery, lokaler Wiederherstellungen und plattformübergreifender Wiederherstellung (z. B. Wiederherstellung von GitHub nach GitLab während eines Ausfalls).
Mehr über RPO und RTO in einer DevOps-Umgebung erfahrenQuellcode gilt oft als das primäre geistige Eigentum eines Unternehmens – er macht jedoch nur einen Bruchteil des tatsächlichen Werts aus, der in Ihrem DevOps-Ökosystem steckt. Metadaten – wie Issues, Pull Requests, Wikis, Kommentare, Commit-Historien und LFS– liefern den entscheidenden Kontext, um diesen Code zu verstehen und einzusetzen. Ohne diese historischen Daten wird selbst vollständig erhaltener Quellcode für Ihr Team extrem schwer navigierbar und kaum deploybar.
Die Automatisierung des Backups dieser Metadaten ist unverzichtbar, denn ihr Verlust führt zu vollständigem organisatorischen Chaos. Stellen Sie sich vor, Sie müssten Ihre Sprint-Planung, Deployment-Historien und Code-Review-Diskussionen aus dem Gedächtnis rekonstruieren. Löscht ein Angreifer Ihre Repositorys oder entfernt ein Benutzer versehentlich ein wichtiges Projekt, lässt Sie ein reines Source-Code-Backup hilflos zurück – Ihr Team verliert wochenlang Zeit damit, Projektstruktur, Abhängigkeiten und Berechtigungen wiederherzustellen.
Eine umfassende automatisierte Backup-Lösung sichert das gesamte DevOps-Ökosystem und stellt sicher, dass alle zugehörigen Metadaten gemeinsam mit dem Code geschützt werden. Tritt ein Notfall ein, stellen Sie Ihre Repositorys in genau dem Zustand wieder her, der unmittelbar vor dem Vorfall bestand – einschließlich aller Rollen, Kommentare und Issue-Verknüpfungen. Diese ganzheitliche Wiederherstellung gewährleistet echte Business Continuity und hält die Produktivität Ihres Teams aufrecht.
Mehr über Metadaten- und Repository-Backup, Recovery und Compliance


